Как мы индексируем клипы по тому, что в них происходит
Теги говорят, о чём клип. Поиск по моментам говорит, когда что происходит. Рассказываем, как устроен конвейер за ним — и чего стоило удержать медианную задержку ниже 40 мс на 41 млн клипов.
 Sara Lindqvist, руководитель направления поиска
28 октября 2026 · 9 мин чтения
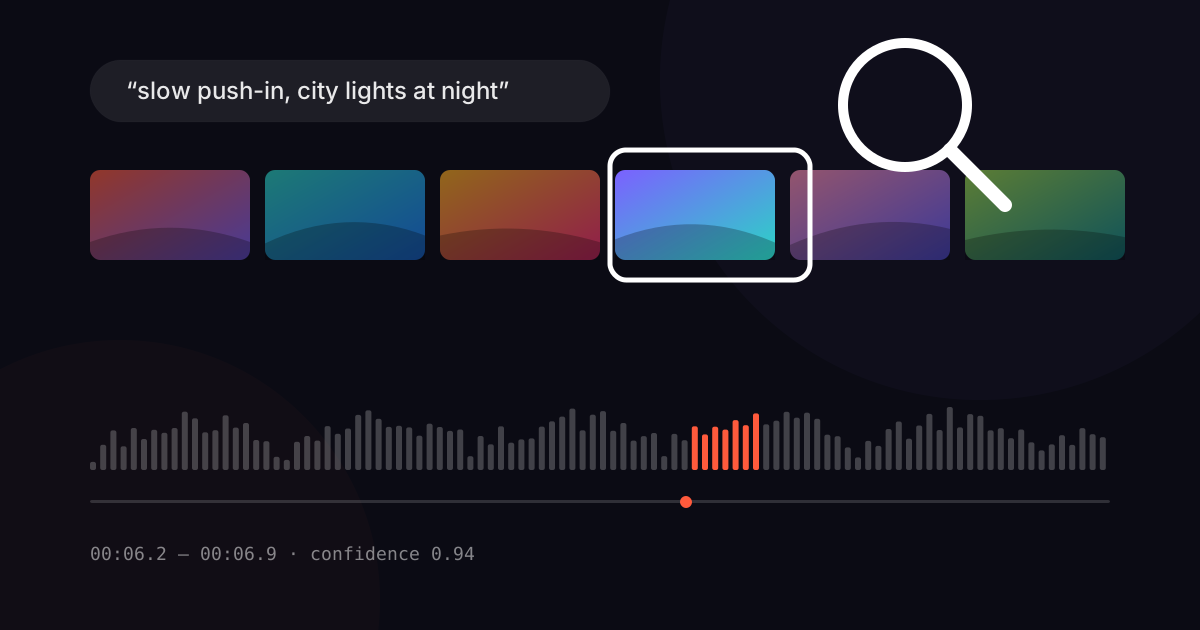
Классический поиск по стокам работает с метаданными: название, описание и пара десятков ключевых слов, которые автор набрал в два часа ночи. Это неплохой сигнал о том, что за клип перед вами. Но он ничего не говорит о том, когда внутри клипа что-то происходит, — а для монтажёра «когда» и есть самое главное.
Поиск по моментам, который мы выпустили в бете в 2025 году и этой осенью пересобрали в версии 2.0, индексирует клипы по тому, что находится в кадре каждые полсекунды.
Шаг 1: разрезать клип на планы
Большинство загрузок — это один план, но примерно в каждой пятой есть склейки, затемнения или титровые карточки. Сначала мы прогоняем лёгкий детектор границ планов, чтобы у каждого плана были собственные эмбеддинги. Без этого шага 10-секундный клип со склейкой на 4-й секунде давал бы размытые, усреднённые результаты.
Шаг 2: описать каждые полсекунды
Для каждого плана мы берём два кадра в секунду и вычисляем:
- визуальный эмбеддинг — от модели «изображение–текст», дообученной на 2,3 млн подписей, написанных монтажёрами;
- дескриптор движения на основе плотного оптического потока: направление, скорость и то, что движется — камера или объект съёмки;
- цветовую сигнатуру: доминирующие оттенки, контраст и цветовую температуру;
- аудиоэмбеддинг, если в клипе есть звук.
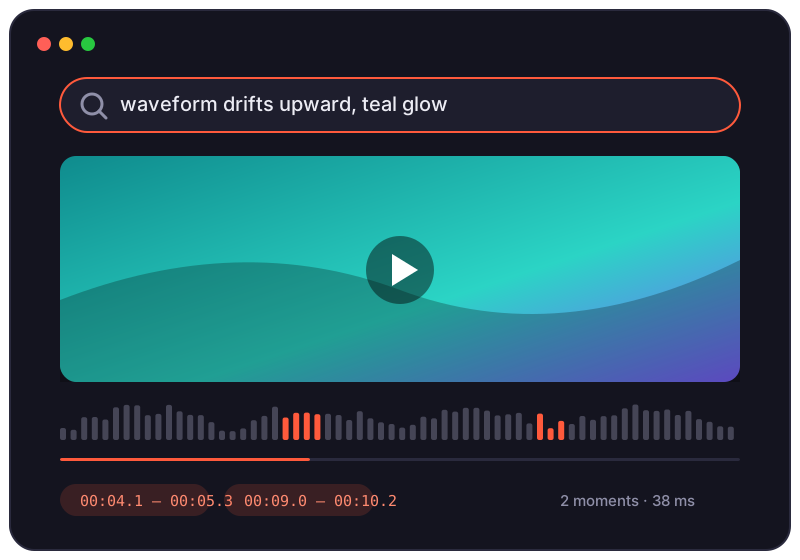
Движение — то, что обычно недооценивают. Наезд и отъезд камеры в отдельном кадре выглядят одинаково: разница видна только во времени. Именно дескрипторы движения позволяют работать запросам вроде «волна плавно уходит вверх».
Шаг 3: индексировать сегменты, а не клипы
Каждые полсекунды становятся сегментом в векторном индексе. 41 млн клипов средней длиной 14 секунд — это примерно 1,1 млрд сегментов, слишком много для наивного перебора. Мы квантуем векторы до 64 байт, шардируем по категориям и держим для каждого шарда небольшой графовый индекс в памяти. Запрос веером расходится по всем шардам, после чего лучшие сегменты объединяются и переранжируются.
| Этап | p50 | p95 |
|---|---|---|
| Кодирование запроса | 6 мс | 11 мс |
| Рассылка по шардам + ANN | 19 мс | 34 мс |
| Объединение и переранжирование | 9 мс | 17 мс |
| Итого (на сервере) | 38 мс | 61 мс |
Шаг 4: сначала ранжировать моменты, затем клипы
Соседние совпавшие сегменты объединяются в интервалы («00:06.2 – 00:06.9»), а итоговая оценка клипа складывается из его лучшего интервала, сигналов качества и того, насколько часто люди с похожими запросами действительно его использовали. Последний сигнал агрегирован и анонимен — персональных поисковых профилей мы не строим.
Что дальше
Сейчас мы работаем над поиском по клипу: загружаете несколько секунд своего материала — и находите моменты, которые хорошо с ним смонтируются. Клиенты тарифа Team, которые хотят попробовать функцию раньше других, могут попросить своего менеджера подключить их к бета-тесту.
Руководитель направления поиска в VideoFinder. Живёт в Варшаве.